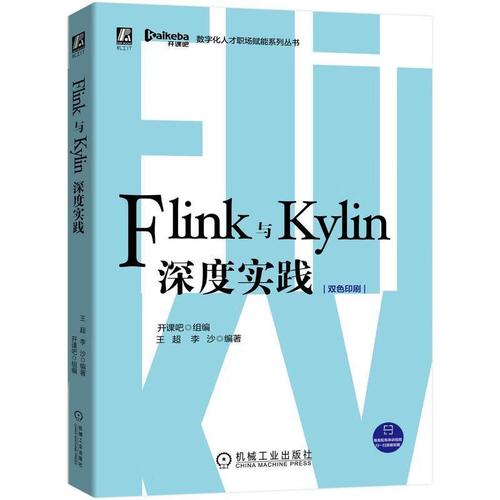
Flink与Kylin深度实践 构建互联网数据服务的高效数据处理与网络服务器分析平台
引言
在当今互联网数据服务快速发展的背景下,计算机与互联网数据处理软件扮演着至关重要的角色。无论是实时流处理还是大规模离线分析,企业对数据价值挖掘的需求日益迫切。Apache Flink 与 Apache Kylin 作为大数据领域的两大明星项目,分别代表了流计算与联机分析处理(OLAP)的顶尖能力。将二者深度结合,并在网络服务器与互联网数据服务场景中落地实践,已成为构建高性能数据平台的重要路径。本文将从技术原理、集成方式、实践案例及优化策略四个维度,深入探讨 Flink 与 Kylin 的联合应用。
一、Flink 与 Kylin 技术定位概述
1.1 Apache Flink:流批一体的计算引擎
Flink 是一个面向分布式数据流处理和批处理的开源计算框架。其核心优势在于:
- 事件时间语义与 Exactly-Once 一致性:保证数据处理的准确性与可靠性,尤其适合网络服务器日志、用户行为流等实时场景。
- 状态管理与容错机制:通过 Checkpoint 和 Savepoint 实现故障恢复,支撑 7×24 小时互联网数据服务。
- 高吞吐低延迟:在计算机与互联网数据处理软件中,Flink 能同时满足毫秒级延迟与大规模吞吐。
1.2 Apache Kylin:亚秒级 OLAP 引擎
Kylin 是专为 Hadoop 生态设计的分布式分析引擎,通过预计算 Cube 实现多维分析。其特点包括:
- 预计算加速:将复杂查询转化为对预建 Cube 的扫描,响应时间可降至亚秒级。
- SQL 接口与 BI 集成:支持标准 SQL,便于与 Tableau、Superset 等工具对接。
- 可扩展的数据源:支持 Hive、Kafka、Spark 等多种数据源接入。
二、Flink 与 Kylin 的集成架构设计
2.1 为什么需要 Flink + Kylin?
传统架构中,实时流处理(Flink)与 OLAP 分析(Kylin)往往相互隔离,导致:
- 实时数据无法快速进入分析仓库;
- 离线 Cube 构建周期长,难以应对互联网数据服务的即时查询需求;
- 网络服务器产生的海量日志缺乏统一的处理管道。
通过深度集成,可实现 “实时入湖 + 预计算加速 + 交互式查询” 的一体化数据服务。
2.2 典型架构分层
| 层级 | 组件 | 职责 |
|------|------|------|
| 数据采集 | Flume、Logstash、Kafka | 从网络服务器采集日志与指标 |
| 实时计算 | Apache Flink | 清洗、聚合、维表关联、写入数据湖/仓 |
| 存储 | HDFS、Hudi、Iceberg、Kafka | 存储原始与加工后数据 |
| 预计算 | Apache Kylin | 基于 Hive/Spark 构建 Cube |
| 查询服务 | Kylin Query Server | 提供 REST API / JDBC 接口 |
| 可视化 | Superset、Grafana | 面向互联网数据服务的报表与监控 |
2.3 集成关键点
- Flink 实时写入 Hive:通过 Flink Hive Connector 或 Flink SQL 将流数据写入 Hive 分区表,作为 Kylin 的数据源。
- Flink 写入 Kafka 后由 Kylin 流式构建:Kylin 3.0+ 支持 Kafka 流式数据源,可实现 Cube 的近实时构建,但需注意微批粒度与容错。
- 维表与 Cube 设计对齐:Flink 作业中使用的维表应与 Kylin Cube 的维度保持一致,避免数据口径偏差。
三、深度实践案例:网络服务器日志实时分析
3.1 场景描述
某互联网数据服务提供商拥有数千台网络服务器,需要实时分析访问日志,实现:
- 每分钟级 PV/UV 统计;
- 按地区、URL、状态码多维下钻;
- 异常流量报警;
- 历史数据亚秒级查询。
3.2 实践步骤
Step 1:数据采集与接入
网络服务器通过 Filebeat 将访问日志发送至 Kafka,Topic 按业务分区。
Step 2:Flink 实时处理
使用 Flink DataStream API 或 Flink SQL 实现:
`sql
-- Flink SQL 示例:解析 Kafka 中的 JSON 日志
CREATE TABLE server_log (
ts BIGINT,
ip STRING,
url STRING,
status INT,
region STRING,
WATERMARK FOR ts AS ts - INTERVAL '5' SECOND
) WITH (
'connector' = 'kafka',
'topic' = 'server-log',
'properties.bootstrap.servers' = 'kafka:9092',
'format' = 'json'
);
-- 每分钟聚合 PV/UV
INSERT INTO hivecatalog.db.pvuv1min
SELECT
TUMBLESTART(ts, INTERVAL '1' MINUTE) AS windowstart,
region,
COUNT(*) AS pv,
COUNT(DISTINCT ip) AS uv
FROM serverlog
GROUP BY TUMBLE(ts, INTERVAL '1' MINUTE), region;`
将异常状态码(如 5xx)实时写入告警队列。
Step 3:数据入仓
聚合后的数据通过 Flink Hive Sink 写入 Hive 分区表,按日期与小时分区,便于 Kylin 构建。
Step 4:Kylin Cube 构建
在 Kylin 中定义数据模型:
- 事实表:pvuv1min(包含 pv、uv 等度量)
- 维度:time(窗口开始时间)、region、status、url
- Cube 粒度:按天分区,按 region + time 聚合
增量构建 Cube,设置自动合并与保留策略。
Step 5:查询服务与可视化
前端通过 Kylin REST API 或 JDBC 查询 Cube,结合 Grafana 展示实时仪表盘。历史数据查询响应时间从分钟级降至 200ms 以内。
3.3 效果评估
| 指标 | 优化前 | 优化后 |
|------|--------|--------|
| 实时聚合延迟 | 5-10 分钟 | < 30 秒 |
| 多维查询响应 | 10-60 秒 | 0.2-1 秒 |
| 数据覆盖完整性 | 离线 T+1 | 近实时 T+1 分钟 |
| 网络服务器资源占用 | 高(每次查询扫全量) | 低(Cube 预计算) |
四、性能优化与最佳实践
4.1 Flink 侧优化
- 状态后端选择:使用 RocksDB 状态后端支撑大状态,开启增量 Checkpoint。
- 反压监控:通过 Flink Web UI 监控反压,调整并行度与缓冲区。
- 维表关联优化:采用 Lookup Join + 本地缓存,降低对网络服务器(如 Redis/MySQL)的查询压力。
4.2 Kylin 侧优化
- Cube 设计技巧:
- 使用聚合组与联合维度减少 Cube 膨胀;
- 对高基数维度启用编码或分片;
- 合理设置 Rowkey 顺序,将常用过滤维度前置。
- 构建引擎选择:对于大集群,使用 Spark 代替 MapReduce 构建 Cube,提升速度。
- 查询下推:利用 Kylin 的查询下推功能,将部分计算交由底层存储完成。
4.3 系统级协同优化
- 数据格式统一:Flink 写入 Hive 时采用 ORC/Parquet 列式存储,提升 Kylin 读取效率。
- 分区对齐:Flink 写入的分区粒度与 Kylin 增量构建的分区一致,避免全量重建。
- 元数据同步:通过 Hive Metastore 统一管理元数据,确保 Flink 与 Kylin 获取相同 schema。
五、常见问题与解决方案
| 问题 | 原因 | 解决方案 |
|------|------|----------|
| Kylin 构建失败,提示 Hive 表分区无数据 | Flink 写入延迟或分区未提交 | 检查 Flink Checkpoint 与 Hive Sink 提交间隔,设置分区提交延迟 |
| 查询结果与实时统计不一致 | 时间语义或维表不一致 | 统一使用事件时间,对齐 Flink 与 Kylin 维表数据 |
| Cube 膨胀严重,构建耗时 | 维度组合爆炸 | 引入聚合组、必要维度、层级维度 |
| Flink 作业反压高 | 并发不足或外部系统瓶颈 | 提升并行度,优化 Kafka 分区数,增加 Hive 写入批次 |
六、与展望
Flink 与 Kylin 的深度实践,为计算机与互联网数据处理软件领域提供了一套从实时采集、流式计算到预计算加速、交互式查询的完整解决方案。在网络服务器密集型场景下,该架构不仅满足了互联网数据服务对低延迟与高并发的双重需求,还通过资源隔离与预计算显著降低了后端压力。
随着 Flink 与 Kylin 社区的持续演进(如 Flink CDC、Kylin 4.0 对云原生的支持),二者在企业级数据服务平台中的协作将更加紧密。建议开发者在实践中注重数据一致性、Cube 治理与监控告警,构建稳定高效的互联网数据服务基础设施。
参考建议:在入门实践时,可从单业务线日志分析着手,逐步扩展至全域数据服务,避免初期过度设计。
如若转载,请注明出处:http://www.adminjin7.com/product/41.html
更新时间:2026-10-11 23:16:09